上一篇讲了线程的状态和切换方法,还讲了 AQS 的关键概念。这一篇我打算学习 AQS 的常见实现、并发容器,还有阻塞队列和线程池。
AQS 的常见实现
上一篇提到 AQS 核心内容就是:state + 等待队列。接下来我会讲解 ReentrantLock、Semaphore、CountDownLatch 等常见实现。
ReentrantLock
上一篇讲解了一个 Mutex 示例,当时也说明了,它不可重入、不处理中断、非公平锁,而真正被广泛使用的,是 ReentrantLock。
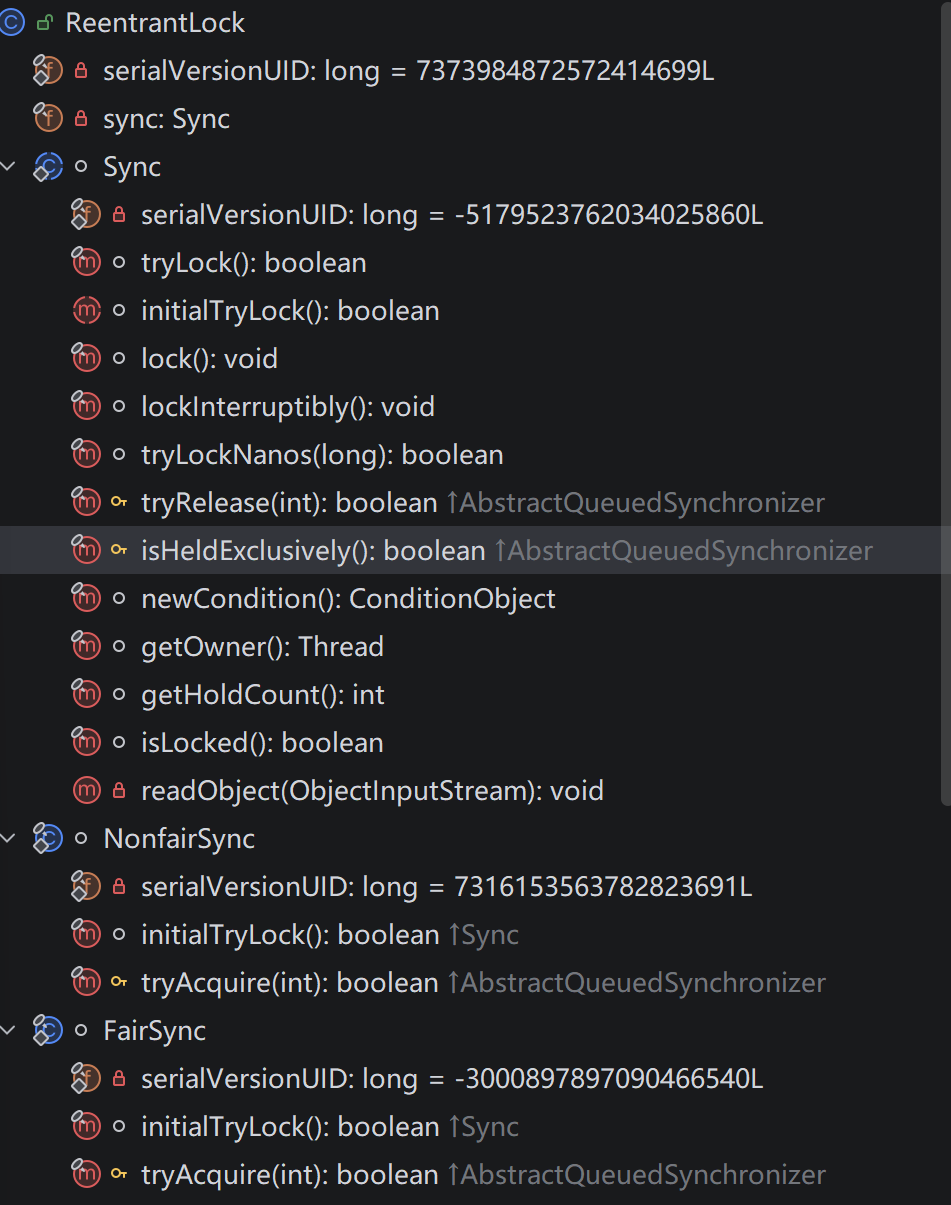
ReentrantLock 和 Mutex 的骨架完全一样,外部类实现 Lock 接口,内部定义一个 Sync 继承 AQS,所有方法委托给 sync 。区别在于 Sync 内部又分了两个子类分别实现非公平锁和公平锁。整体架构如图,剩下没展示的方法基本都是调用 Sync 里的方法。
说实话,我觉得前两篇的内容我都已掌握,但当我实际接触 ReentrantLock 时,我还是迷了,各种函数来回调用,lock()、tryLock()、initialTryLock()、tryAcquire()、acquire() 等等,全部混乱,如果你也这样,继续看下去包能让你满意。
整体架构
public class ReentrantLock implements Lock, java.io.Serializable {
    private final Sync sync;
    abstract static class Sync extends AbstractQueuedSynchronizer {...}
    static final class NonfairSync extends Sync {...}
    static final class FairSync extends Sync {...}
    ...
}从上方图也能看出来,ReentrantLock 内部定义了一个 Sync,AQS的一个实现,不同的是又有两个子类 NonfairSync、FairSync 去继承 Sync 作为公平锁和非公平锁的实现。
查看 ReentrantLock 一些其他的方法可以发现基本都是 sync.xxx(),所以这些方法只是暴露给调用者的 api,真正的核心还是 Sync 里的方法。接下来的重点也还是 Sync 里各种方法的实现。
lock() 调用链
ReentrantLock.lock()
  └── sync.lock()                       // Sync 内部类
        └── initialTryLock()            // 快速尝试(NonfairSync / FairSync 实现)
              ├── 成功:直接返回
              └── 失败:acquire(1)       // AQS 的模板方法
                    └── tryAcquire(1)   // AQS 的钩子(NonfairSync / FairSync 实现)
                          ├── 成功:返回
                          └── 失败:入队、阻塞(AQS 底层,本篇不展开)
可以在 idea 上进行一个简单的调试,就拿之前写过的生产者消费者那个代码来说,到 initialTryLock() 方法就直接返回 true,后续调用就不会进行。
Sync 内部方法
initialTryLock()
/*
这是 jdk21 的新增方法,是个抽象方法,由公平锁和非公平锁各自实现,
主要作用就是减少进入 AQS 队列的开销,能直接抢到就直接抢。后面细说。
*/
abstract boolean initialTryLock();
lock()
/*
也和之前的调用链对应上了,先调 initialtryLock(),
失败了抛给 AQS 的 acquire(1)。
*/
final void lock() {
    if (!initialTryLock())
        acquire(1);
}
tryLock()
/*
这个方法专门给外层 tryLock() API 用,不走 AQS 排队机制。
*/
final boolean tryLock() {
    Thread current = Thread.currentThread();
    int c = getState();
    if (c == 0) {
        //直接 CAS 0->1,成功就返回 true,重入就 state++
        if (compareAndSetState(0, 1)) {
            setExclusiveOwnerThread(current);
            return true;
        }
        //如果当前线程就是独占锁的线程,说明重入。
    } else if (getExclusiveOwnerThread() == current) {
        if (++c < 0) // overflow
            throw new Error("Maximum lock count exceeded");
        setState(c);
        return true;
    }
    return false;
}
tryRelease(int)
/*
Sync 重写 AQS 的钩子,
由 sync.release(1) 调用,release 内部会回调 tryRelease
*/
protected final boolean tryRelease(int releases) {
    int c = getState() - releases;
    //先检查当前线程是不是持有锁的线程
    if (getExclusiveOwnerThread() != Thread.currentThread())
        throw new IllegalMonitorStateException();
    //state 减到0才算真正释放
    boolean free = (c == 0);
    if (free)
        setExclusiveOwnerThread(null);
    setState(c);
    return free;
}lockInterruptibly()和tryLockNanos()
/*
可 中断获取 锁的底层实现
*/
final void lockInterruptibly() throws InterruptedException {
    //如果被中断,直接抛异常
    if (Thread.interrupted())
        throw new InterruptedException();
    //快速尝试获取锁(不排队不阻塞)
    if (!initialTryLock())
        //快速路径失败,进入 AQS 的完整排队 + 阻塞流程
        acquireInterruptibly(1);
}
/*
限时获取锁的底层实现
*/
final boolean tryLockNanos(long nanos) throws InterruptedException {
    if (Thread.interrupted())
        throw new InterruptedException();
    //快速尝试,失败则进入 AQS 的
    //限时排队流程(最多等nanos 纳秒,超时返回false,线程继续执行后续代码)
    return initialTryLock() || tryAcquireNanos(1, nanos);
}- 剩下的
isHeldExclusively()、getOwner()等用来给外面查状态,用来给外面查状态。
NonfairSync 和 FairSync
NonfairSync 核心目标:
- 允许插队:新来线程不管队列里有没有人,直接抢锁。
- 支持重入:同一线程可以多次获取锁。
- 先走快速路径:进入 AQS 排队之前,尽可能先拿到锁,减少上下文切换。
重写两个方法:
initialTryLock():快速路径,在lock()、lockInterruptibly()、tryLock()等入口被调用。tryAcquire(int acquires):AQS 模板方法中的钩子,在acquire(1)内部被调用
static final class NonfairSync extends Sync {
    /*
    initialTryLock() 是一个“快速路径”,
    它把无竞争获取和重入这两种最常见、最廉价的情况一次性处理掉,
    避免进入 AQS 的队列和阻塞逻辑。
    只有在锁确实被其他线程占用时,才走重量级流程。
    */
    final boolean initialTryLock() {
        Thread current = Thread.currentThread();
        //插队行为
        if (compareAndSetState(0, 1)) { // first attempt is unguarded
            setExclusiveOwnerThread(current);
            return true;
        } else if (getExclusiveOwnerThread() == current) {
            int c = getState() + 1;
            if (c < 0) // overflow
                throw new Error("Maximum lock count exceeded");
            setState(c);
            return true;
        } else
            return false;
    }
    /**
     * Acquire for non-reentrant cases after initialTryLock prescreen
     */
    //上边的原始注释也说了,在 initialTryLock 预筛选后,用于处理非重入情况。
    //acquire(1) 会调用 tryAcquire(1),
    //此时当前线程一定不是锁的持有者(如果是就走 initialTryLock() 了)
    protected final boolean tryAcquire(int acquires) {
        if (getState() == 0 && compareAndSetState(0, acquires)) {
            setExclusiveOwnerThread(Thread.currentThread());
            return true;
        }
        //不处理重入,因为在上面函数处理过了
        //不检查等待队列,因为非公平锁允许插队。
        return false;
    }
}
为什么需要 tryAcquire ?因为存在一种情况:(先回头看眼 lock())
- 线程调用
initialTryLock()时,锁被其他线程持有,返回false。 - 在进入
acquire(1)之前,锁被释放了,state变为 0。 - 此时
tryAcquire(1)就有机会再次 CAS 抢锁,成功则直接获取,无需入队。
FairSync 是公平锁的实现,在构造 ReentrantLock 时传入 true 即可创建公平锁。核心目标为:
- 严格 FIFO:新来的线程如果发现等待队列里有前辈排队,就必须乖乖去队尾,不允许插队。
- 支持重入:同一个线程可以多次获取锁。
- 牺牲吞吐量换公平性:避免“线程饥饿”,但增加了唤醒开销。
重写的两个方法整体和 NonfairSync 类似,多了两个方法 hasQueuedThreads() 和 hasQueuedPredecessors(),前者是检查队列里有没有任何线程在排队,后者是检查队列里有没有比当前线程等得更久的前辈。
static final class FairSync extends Sync {
    /**
     * Acquires only if reentrant or queue is empty.
     */
    final boolean initialTryLock() {
        Thread current = Thread.currentThread();
        int c = getState();
        if (c == 0) {
            if (!hasQueuedThreads() && compareAndSetState(0, 1)) {
                setExclusiveOwnerThread(current);
                return true;
            }
        } else if (getExclusiveOwnerThread() == current) {
            if (++c < 0) // overflow
                throw new Error("Maximum lock count exceeded");
            setState(c);
            return true;
        }
        return false;
    }

    /**
     * Acquires only if thread is first waiter or empty
     */
    //上面说 仅当当前线程是队首或者队列为空时才会获取。
    //hasQueuedThreads() = 队列里有没有人?
    //hasQueuedPredecessors() = 我前面有没有人?
    //后者考虑到到了当前线程是队首的情况
    protected final boolean tryAcquire(int acquires) {
        if (getState() == 0 && !hasQueuedPredecessors() &&
            compareAndSetState(0, acquires)) {
            setExclusiveOwnerThread(Thread.currentThread());
            return true;
        }
        return false;
    }
}至此,ReentrantLock 基本讲完了,至于 AQS 内部的排队唤醒机制,大概就是“自旋 -> 挂起 -> 醒来 -> 再自旋”这样一个循环。总结一下 ReentrantLock 的两种实现。
| 对比项 | NonfairSync | FairSync |
|---|---|---|
initialTryLock() 锁空闲时 | 直接 CAS 抢 | 先查 hasQueuedThreads(),队列非空就不抢 |
tryAcquire() 锁空闲时 | 直接 CAS 抢 | 先查 hasQueuedPredecessors() ,有前辈就不抢 |
| 重入 | 支持 | 支持 |
| 插队 | 支持 | 不支持 |
| 吞吐量 | 高 | 低(多了检查 + 更多线程挂起/唤醒) |
| 线程饥饿 | 会发生 | 不会发生 |
| 使用场景 | 多数场景 | 对公平性有严格要求的场景 |
Semaphore
state 表示当前可用的许可数量,acquire() 减1,release() 加1,减到0时后来的线程排队等待。共享模式。
常用方法:
| 方法 | 作用 |
|---|---|
acquire() | 申请1个许可证,阻塞直到成功 |
acquire(int n) | 申请n个许可证 |
tryAcquire() | 尝试申请,成功返回 true,失败立即返回 false |
tryAcquire(long timeout, TimeUnit unit) | 限时尝试申请 |
realease() | 归还一个许可证 |
availablePermits() | 查看当前剩余许可证数量 |
使用场景:限流——控制同时访问某个资源的线程数量。比如模拟只有3个停车位的停车场。
下面是一个示例。输出是会错位的,因为获取许可和打印、释放许可和打印,这些步骤不是原子的。比如线程 A 释放了信号量,线程 B 立刻拿到,此时打印的剩余许可证数量还是不变。
class SemaphoreExample {
    Semaphore parking = new Semaphore(3);
    public void park() {
        for (int i = 0; i < 10; i++) {
            int carId = i;
            new Thread(() -> {
                try {
                    parking.acquire();
                    System.out.println("车辆:" + carId +
                            "停入,剩余车位:" + parking.availablePermits());
                    Thread.sleep(2000);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                } finally {
                    parking.release();
                    System.out.println("车辆:" + carId +
                            "离开,剩余车位:" + parking.availablePermits());
                }
            }).start();
        }
    }
}
CountDownLatch
这个算是比较简单的一个。state 表示还需要倒数的计数,countDown() 减 1,减到 0 时所有 await() 的线程被唤醒。共享模式,一次性。如果需要重置 state,可以考虑用 CyclicBarrier。
使用场景:主线程等 n 个子线程初始化完毕再开始主流程。比如开一局 PUBG,需要等地图、玩家等资源准备好了才会开。
class CountDownLatchExample {
    String[] resources = new String[]{"map", "role"};
    CountDownLatch pubg = new CountDownLatch(resources.length);
    public void load() throws InterruptedException {
        for (String resource : resources) {
            new Thread(() -> {
                try {
                    Thread.sleep(2000);
                    System.out.println(resource + "加载完成");
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                } finally {
                    pubg.countDown();
                }
            }).start();
        }
        System.out.println("等待资源加载中");
        pubg.await();
        System.out.println("资源加载完成,上飞机。");
    }
}
ReentrantReadWriteLock
这个复杂到爆。可以通过 readLock() 和 writeLock() 拿到两把锁,然后各自调用 lock() 和 unlock()。读锁是共享模式,写锁是独占模式,因为实现了 Lock 接口,所以使用和 ReentrantLock 一样。读锁的共享体现在 读 和 读 之间,互斥体现在 读 和 写 之间。它的 state 被拆成高16位和低16位,高16位记录读锁计数,有多少个线程在读,低16位记录写锁的重入次数。
使用场景:读多写少的缓存。多个线程可以同时读缓存,但写缓存必须独占。
阻塞队列
BlockingQueue 是 Queue 的一个子接口,相比 Queue ,它提供了阻塞操作,同时所有实现都保证线程安全。
简单介绍
下面是方法对照表,后两列是 BlockingQueue 独有的。
| 操作 | 抛异常 | 返回特殊值 | 一直阻塞 | 超时阻塞 |
|---|---|---|---|---|
| 插入 | add(e) | offer(e) -> false | put(e) | offer(e, time, unit) |
| 移除 | remove() | poll() -> null | take() | poll(time, unit) |
| 检查 | element() | peek() -> null | 无 | 无 |
阻塞的意思就是,拿 put() 来说,队列如果满时就会一直阻塞,知道有空位才会把元素放进去,offer() 的是意思这一段时间内有空位就放进去,如果没有空位返回 false,如果是 poll() 超时就返回 null。
null 也引出了一条规则,在 BlockingQueue 接口的所有实现里,都不允许放入 null 元素,因为 poll() 用 null 表示拿不到,如果允许存 null 二者就会产生歧义。LinkedList 作为 Queue 的接口实际上是可以插入 null 的,注意是允许,不代表这个操作正确,它可以插入 null 是为了兼容早期代码,当时 LinkedList 是作为 List 实现的,而 Queue 接口是后面随 JUC 引入的,那时 LinkedList 被追加实现了 Queue/Deque,所以它只是个意外。 其实 JUC 里的很多实现类都不允许 null 元素,要么破坏类的原有的实现语义,要么拿 null 有特殊用处。
用阻塞队列重写生产者消费者
public class BlockingQueueProducerConsumer {
    private static final BlockingQueue<Integer> queue = new ArrayBlockingQueue<>(5);
    private static final Random rand = new Random();
    public static void main(String[] args) {
        Thread producer = new Thread(() -> {
            while (true) {
                try {
                    int value = rand.nextInt(100);
                    queue.put(value);
                    System.out.println("produce:" + value + ", queue.size = " + queue.size());
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                    break;
                }
            }
        });

        Thread consumer = new Thread(() -> {
            while (true) {
                try {
                    Integer value = queue.take();
                    System.out.println("consume:" + value + ", queue.size = " + queue.size());
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                    break;
                }
            }
        });
        producer.start();
        consumer.start();
    }
}
可以看到不需要再定义 lock、condition,不用再判断队列是否满,因为这些逻辑已经在 BlockingQueue 里封装好了,其实看一下 put() 和 take() 方法的源码就会发现和以前用 ReentrantLock 和 Condition 实现的那一套生产者消费者很像。
我觉得有一点细节值得一说:当捕获到异常时应该 Thread.currentThread().interrupt(); 而不是继续向上抛RuntimeException,interrupt() 的意义在于恢复中断标志,如果像之前那样抛 RuntimeException 会让线程直接死掉,另一个线程永久阻塞。
中断机制
详细讲一下中断机制吧,我在这里迷了好久。
首先要知道:
中断不是强制杀线程,而是协作式通知。
一个线程是否中断是从
Thread类里的interrupted的布尔值来判断的,true 中断。Thread.currentThread().isInterrupted()这个方法用来返回线程的中断状态。t.interrupt()用来中断线程 t,它会把中断标志设为 true,同时如果当前线程正在阻塞,也会通知 JVM 去唤醒。当线程执行
Thread.sleep()、Object.wait()、Thread.join()这些方法被中断时,除了抛出异常,必须清除中断状态。也就是说:凡是声明了throws InterruptedException的可中断阻塞方法,因中断而抛出异常时,必须清除中断状态(清除中断状态的是sleep()这些方法,而不是interrupt())。
所以时间线是
别人调用 t.interrupt()
    ↓
t 的中断标志变成 true
    ↓
t 正卡在 sleep()
    ↓
sleep() 被唤醒,发现中断标志是 true
    ↓
sleep() 清掉中断标志,设为 false
    ↓
sleep() 抛出 InterruptedException
所以再回看上面这段文字:
当捕获到异常时应该
Thread.currentThread().interrupt();而不是继续向上抛RuntimeException,interrupt()的意义在于恢复中断标志
因为异常抛出时,中断标志被清除掉了,如果不能把异常继续往上抛,又不恢复标志,上层就不知道这个线程被中断过,即“吞掉中断”。在生产者消费者的例子里并没有任何地方调用 interrupt(),但在实际项目中,很多地方都会显示或隐式调用,比如 ExecutorService.shutdownNow()。
但不要搞混 break 和 Thread.currentThread().interrupt(); 的作用,前者是结束 while 循环,从而结束 run 方法,后者只是设置标志,保存中断状态。(其实在这个例子中不要 break,循环条件换为 Thread.currentThread().interrupt() 也是可以的)。小提醒,不要搞混 isInterrupted() 和 interrupted()。
总结一下,推荐这样写:
public void run() {
    while (!Thread.currentThread().isInterrupted()) {
        try {
            // 干活
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            // 不能继续抛 InterruptedException 时,恢复中断状态
            Thread.currentThread().interrupt();
            // 停止当前循环/任务
            break;
        }
    }
    // 清理资源
}刷抖音看见一个同学分享的美团面经,面试官让手撕一道题,内容如下
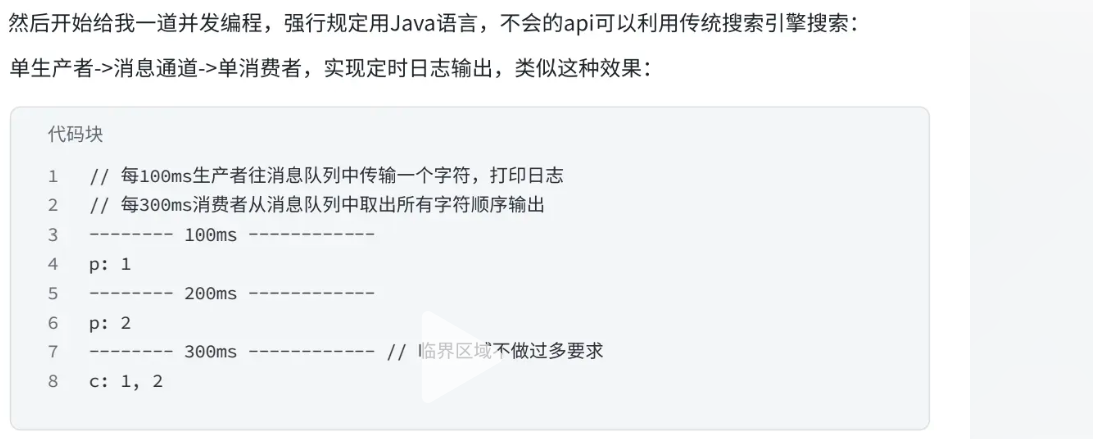
我的答案是这样的,问题就是时间点无法精确打印。
class MeiTuanTest {
    public void print1() {
        BlockingQueue<Integer> queue = new ArrayBlockingQueue<>(10);
        AtomicInteger i = new AtomicInteger(1);
        long start = System.currentTimeMillis();
        Thread p = new Thread(() -> {
            while (!Thread.currentThread().isInterrupted()) {
                try {
                    Thread.sleep(100);
                    System.out.println("-------- " + (System.currentTimeMillis() - start) + "ms ----------");
                    int value = i.getAndIncrement();
                    queue.put(value);
                    System.out.println("p: " + value);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                    break;
                }
            }
        });
        Thread c = new Thread(() -> {
            while (!Thread.currentThread().isInterrupted()) {
                try {
                    Thread.sleep(300);
                    List<Integer> list = new ArrayList<>();
                    queue.drainTo(list);
                    System.out.println("c: " + list.toString());
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                    break;
                }
            }
        });
        p.start();
        c.start();
    }
}
常见实现
| 实现 | 数据结构 | 是否有界 | 特点 | 典型场景 |
|---|---|---|---|---|
ArrayBlockingQueue | 数组 | 有界 | 一把锁两个Condition | 固定容量缓冲 |
LinkedBlockingQueue | 链表 | 默认int最大值,可选有界 | 两把锁,吞吐量更高 | 线程池任务队列 |
SynchronousQueue | 不存储元素 | 无容量 | 每个 put 必须等待 take,反之亦然 | newCachedThreadPool |
PriorityBlockingQueue | 堆 | 无界 | 按优先级出队 | 优先级任务 |
DelayQueue | 堆+延迟 | 无界 | 到期才能take | 定时任务 |
简单讲一下后四个,涉及到线程池的后面会具体讲。
LinkedBlockingQueue 底层是链表,它入队和出队用的是两把锁 putLock 和 takeLock,notFull 和 notEmpty 两个条件也是分别绑在两个锁上。所以生产者可以和消费者同时进行,这是它吞吐量更高的原因。但它的默认容量是 Integer.MAX_VALUE ,几乎等于无界,当生产速度远大于消费速度时,任务会无限堆积,最终 OOM,使用时建议指定容量。线程池 Executors.newFixedThreadPool() 用的就是它。
SynchronousQueue 它不存储元素。可以看一下这个类的 size()、isEmpty() 等方法。它的语义不是“把元素放进队列”,而是“把元素直接交给另一个线程”。所以:
put(e)会阻塞,直到有另一个线程调用take()。take(e)会阻塞,直到有另一个线程调用put(e)。
它一手交钱,一手交货,没有中间商赚差价。它的内部也有公平和非公平两种模式,默认非公平。Executors.newCachedThreadPool() 用的就是它。
PriorityBlockingQueue 是一个有优先级的无界阻塞队列,只有一个 notEmpty 一个条件,所以可以无限 offer 直至 OOM,因为有优先级,所以元素必须可比较。
DelayQueue 也是一个无界阻塞队列。元素必须实现 Delayed 接口,它的语义是只有到期元素 才可能被 take() 。内部用到了 PriorityQueue ,按到期时间排序,队首永远是最早到期的元素。
常见的实现讲完了,接下来就是线程池。看完默认线程池对工作队列的选择,或许会清楚为什么说一定要自定义线程池。
线程池
ThreadPoolExecutor
JUC-2 里讲了四种常见的创建线程的方式,如果使用前三种,会有很多缺点。
手动创建线程的缺点
- 创建和销毁线程需要分配和收回资源,如果每个任务都需要新建一个线程,那开销会很大。
- 线程数量不可控,来一个任务 new 一个 thread,并发请求一多会 OOM,同时上下文切换的开销也会很大。
- 缺乏管理和监控,无法统一管理各个线程的生命周期。
线程池弥补了这些缺点。它会预先创建一批线程,用这些线程反复在任务队列里取任务执行,用完不销毁,放进池子里等待下一批任务。这是一种思想,数据库连接池、对象池都是同样的想法。
线程池相关接口和类
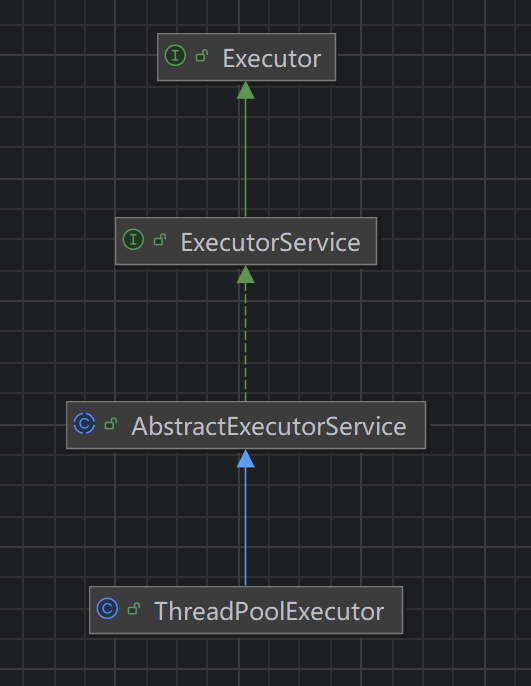
Executor 接口:最顶层接口,只有一个方法 execute(Runnable command) 。
ExecutorService 接口:继承 Executor 接口,增加了 submit、shutdown 等相关的生命周期管理方法。
AbstractExecutorService 抽象类:把 submit() 等方法的通用逻辑抽取出来。方便实现类复用。这是《Effective Java》里推荐的“接口 + 骨架实现类”的组合,也叫模拟多重继承。
ThreadPoolExecutor 类:真正的线程池实现。
Executors 类:提供多种线程池实现和线程工厂的实现。
我和 ai 交流,它说了下面这样一段话:
Executor这个接口的设计哲学很有意思:把“任务的提交”和“任务的执行”解耦。提交任务的人不需要知道任务是被哪个线程执行的、是新建线程还是复用线程、是立即执行还是排队。这是线程池所有灵活性的来源。
我尝试理解了一下,比如下面这个例子,调用这个方法时,你可以传入不同的 Executor 实现,但都不影响“任务的提交”。
public void doWork(Executor executor) {
    executor.execute(() -> System.out.println("任务执行"));
}
大概是这个意思,但说实话我始终有点迷惑,也许一年后再回看会清楚很多。
七大参数
这简直是面试超超高频考点,七个参数分别为:核心线程数、最大线程数、空闲线程存活时间、时间单位、工作队列、线程工厂、拒绝策略。
public ThreadPoolExecutor(int corePoolSize,
                              int maximumPoolSize,
                              long keepAliveTime,
                              TimeUnit unit,
                              BlockingQueue<Runnable> workQueue,
                              ThreadFactory threadFactory,
                              RejectedExecutionHandler handler) {...}
在介绍参数前先吟诵一下八股:任务的执行流程:
- 提交任务时,如果当前线程数小于核心线程数,那么创建新线程执行任务。
- 如果当前线程数大于核心线程数,那么将任务加入工作队列。
- 如果工作队列已满,且当前线程数小于最大线程数,创建新线程来执行任务。
- 如果工作队列已满且当前线程数等于最大线程数,执行拒绝策略。
- 当前线程数大于核心线程数时,超过空闲线程存活时间的空闲线程将被回收。
核心线程数和最大线程数
核心线程数是线程池长期维持的线程数量,默认即使空闲也不会被销毁。最大线程数是线程池能创建线程的上限,多出来的线程是非核心线程。实际上二者只是逻辑上的区分。一般来说,推荐把二者设为相同值,避免线程池在运行时频繁创建和销毁线程,减少开销。
空闲线程存活时间和时间单位
非核心线程空闲超过该时间则会被销毁,如果设置了 allowCoreThreadTimeOut(true),核心线程也会受到约束。时间单位一般用秒或毫秒。
工作队列
存放等待执行任务的阻塞队列,就是上面讲的 BlockingQueue。
线程工厂
用于创建线程,默认实现是 Executors.defaultThreadFactory(),创建的线程都在同一个线程组,优先级相同,是非守护线程。一般会自定义,给线程起带有业务含义的名字,方便排查问题。
拒绝策略
线程数达到最大值,队列也满,此时会按照定义的拒绝策略来拒绝新提交的任务。有四种内置实现:
| 策略 | 行为 | 适用场景 |
|---|---|---|
AbortPolicy | 直接抛 RejectedExecutionException | 默认策略,需要感知拒绝 |
CallerRunsPolicy | 由提交任务的线程自己执行 | 不希望丢任务,且能接受提交线程被阻塞 |
DiscardPolicy | 静默丢弃,不抛异常 | 允许丢任务,但很难排查问题 |
DiscardOldestPolicy | 丢弃队列中最老的任务,再提交当前任务 | 允许丢弃老任务,保留新任务 |
注意事项
线程池不允许用
Executors去创建,因为里面提供的线程池都存在弊端,原因在参数上,如下表,要么队列无界,要么线程数无界,都会导致OOM。工厂方法 核心线程 最大线程 队列 newFixedThreadPooln n LinkedBlockingQueue(无界)newSingleThreadExecutor1 1 LinkedBlockingQueue(无界)newCachedThreadPool0 Integer.MAX_VALUESynchronousQueuenewScheduledThreadPooln Integer.MAX_VALUEDelayedWorkQueue所一般来说,会把核心线程数和最大线程数设为相同的值,避免开销,然后配置有界队列。
我想讲一下缓存线程池,为什么称它为缓存,这取决于用的队列。关于
SynchronousQueue,上面讲过,它的特点是不存储元素,把元素交给另一个线程。相当于工作队列长度为 0。按照任务提交流程走,因为核心线程数为 0,所以会直接尝试把任务进队,如果没有空闲线程在等待(也就是没有线程去take),那就入队失败,而当前线程数肯定是小于最大线程数的(无限大),所以会创建新线程来执行任务。新线程执行完任务后会循环从队列里去任务,如果 60 秒内有新任务提交,那就一手交钱一手交货,如果没有,线程被回收。所以,如果同时来多个任务,且没有空闲线程,每个任务都会导致创建一个新线程,线程数是弹性增长的。优雅关闭。线程池用完要关闭,否则 JVM 不会退出(非守护线程还在跑)
executor.shutdown();       // 不接受新任务,处理完队列里的任务后关闭
executor.shutdownNow();    // 不接受新任务,中断正在执行的任务,返回未执行的任务列表
监控。可以通过
getPoolSize()、getActiveCount()等方法对线程池状态进行监控。
ForkJoinPool
简单讲一下,有一类任务,本身很庞大,但是可以被递归拆成很多小任务,每个小任务算完还要把结果合并,类似归并排序。如果把这种任务交给 ThreadPoolExecutor ,只有一个线程在猛猛干,其他线程闲着,ForkJoinPool 就是为了解决这样一个问题。
ForkJoinPool 继承自 AbstractExecutorService ,和 ThreadPoolExecutor 是同级别线程池实现。核心思想是分治:fork,拆;join,合。
这两个线程池最大的区别在于队列设计:
ThreadPoolExecutor:全局一个队列,所有线程抢同一个队列。ForkJoinPool:每个线程一个双端队列,自己从头部取任务,空闲时去别人队列尾部(任务粒度达,偷过来可以再拆)“偷”。
所以,ForkJoinPool 适合任务之间有依赖、需要拆分的场景;ThreadPoolExecutor 适合任务相互独立的场景。
虚拟线程
前面的的线程池解决的问题是:创建销毁线程开销达,所以池化来复用。虚拟线程的解决思路是,让 创建和销毁线程的开销变得极小。
虚拟线程是 JDK21 正式引入的轻量级线程,由 JVM 管理,不绑定操作系统的线程。
具体不再细说,从 Thread、Executors 等各种类里也可以看到虚拟线程的踪迹。
总结
到这里 JUC 基本上结束了,但这只是冰山一角,庞大的并发包可以用一整本书来讲。这三篇内容我也并不是百分百理解,希望以后常看常新。